Le 7 octobre 2026, Mistral AI a ouvert l'accès public preview à Mistral Large 4, son nouveau modèle frontier. Fenêtre de contexte d'1 million de tokens, capacités multimodales natives (texte + image + document), et surtout : poids ouverts sous licence commerciale, hébergement possible en France, et une API disponible via Mistral Studio. Pour les PME françaises qui hésitaient à passer à l'IA par peur de dépendre d'OpenAI ou Google, c'est un signal fort. On décrypte ce que cette sortie change vraiment, sans hype, et on vous donne 5 cas d'usage concrets à tester cette semaine.
Ce qui a été annoncé le 7 octobre 2026
Mistral a publié Large 4 en preview publique sur son API le 7 octobre 2026, dans le cadre d'une vague de sorties frontier qui a vu Google, OpenAI, Anthropic et Mistral dévoiler de nouveaux modèles sur une même quinzaine. Les trois caractéristiques annoncées qui comptent pour les PME :
Fenêtre de contexte 1M tokens : vous pouvez injecter l'équivalent de 2 500 pages dans un seul prompt. Un dossier client complet, un cahier des charges, une base de connaissances entière.
Multimodal natif : le modèle lit les images, les PDF scannés, les captures d'écran, les schémas. Pas besoin d'OCR séparé.
Poids ouverts + hébergement souverain : vous pouvez faire tourner le modèle sur une infrastructure européenne (OVHcloud, Scaleway) ou on-premise. Les données ne quittent pas l'UE.
L'accès se fait via Mistral Studio, l'interface console officielle, ou via API REST compatible avec les SDK existants.
Pourquoi c'est important pour les PME françaises
Jusqu'à présent, une PME qui voulait déployer un agent IA sérieux se retrouvait face à un dilemme : utiliser GPT-4 ou Claude (performants mais hébergés aux US, avec un cadre RGPD acrobatique), ou se replier sur des modèles open source moins capables. Mistral Large 4 referme ce gap.
Le contexte réglementaire renforce l'intérêt. L'AI Act entre en application progressive, la CNIL a publié ses recommandations sectorielles, et les clients grands comptes exigent désormais des garanties sur la localisation des données. Si vous ne maîtrisez pas où vos prompts partent, vous perdrez des appels d'offres. On en parlait déjà dans notre guide sur les règles AI Act et CNIL pour les PME en 2026.
Deuxième effet : le coût. Mistral annonce un pricing API environ 40% inférieur à GPT-4 Turbo sur les tokens d'entrée, ce qui change le calcul ROI sur les cas d'usage à fort volume (classification de tickets, résumés quotidiens, génération de contenu).
5 cas d'usage souverains à déployer dès maintenant
1. Analyse de dossiers clients longs (assurance, courtage, juridique)
Avec 1M tokens de contexte, vous injectez un dossier client complet (contrats, échanges mail, pièces jointes) et demandez une synthèse structurée. Un courtier en assurance peut traiter en 30 secondes un dossier sinistre qui prenait 2 heures. Le modèle lit les PDF scannés nativement, pas besoin d'étape OCR en amont.
2. Vision documentaire pour la facturation et les devis
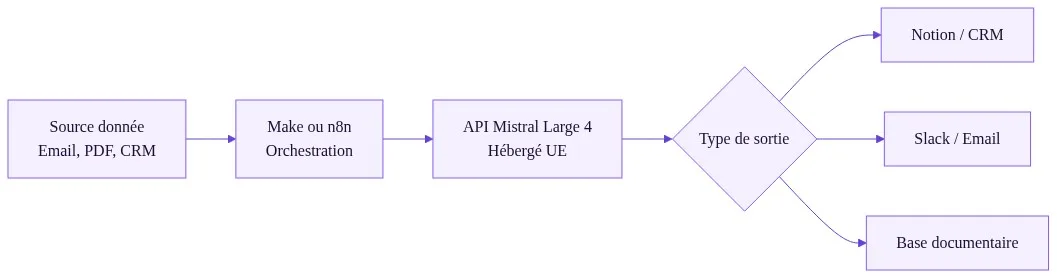
Mistral Large 4 extrait structurellement les informations d'une facture fournisseur scannée, d'un devis manuscrit, d'un bon de livraison photographié. Vous branchez Make en entrée (email → pièce jointe), Mistral en traitement, et votre outil compta (Pennylane, Qonto, Sage) en sortie.
3. Agent de support client interne
Vous injectez toute votre documentation interne (processus, FAQ, historique tickets) dans le contexte et vous obtenez un assistant RAG light sans vectorisation complexe. Idéal pour les équipes ops ou RH qui reçoivent 50 fois la même question par semaine. Pour aller plus loin sur l'intégration no-code, on détaille dans notre guide n8n + Mistral conforme RGPD.
4. Qualification et enrichissement de leads commerciaux
Un commercial reçoit un formulaire web. Mistral analyse le contexte (site de l'entreprise, LinkedIn du prospect, historique CRM), score le lead, propose un email de première approche personnalisé. Le tout sans envoyer la donnée hors UE, point critique si vos prospects sont des hôpitaux, des collectivités ou des grands comptes régulés.
5. Génération de reporting hebdomadaire multi-sources
Chaque lundi matin, un workflow Make agrège les données de la semaine (ventes, support, marketing), les passe à Mistral avec un prompt de synthèse, et envoie un rapport exécutif sur Slack ou par mail. Avec le contexte 1M, vous n'êtes plus obligé de pré-filtrer les données en amont.
Ce que disent les experts
« La sortie quasi-simultanée de modèles frontier par Google, OpenAI, Anthropic et Mistral fin octobre 2026 marque un rééquilibrage : pour la première fois, un acteur européen propose un modèle compétitif sur les benchmarks tout en offrant une vraie option d'hébergement souverain. »
Dutch Startup AI, analyse frontier models octobre 2026
« Mistral Large 4 enters public API preview with multimodal support and extended context. The combination of open weights and competitive pricing shifts the equation for European businesses evaluating LLM infrastructure. »
Open Data Science, Last Week in AI, 12 octobre 2026
« n8n se positionne comme la plateforme d'orchestration privilégiée pour les workflows IA souverains en 2026, notamment grâce à son modèle self-hosted qui permet de garder les données en interne tout en appelant des modèles comme Mistral en API privée. »
DevToolLab, comparatif n8n vs Zapier vs Make, octobre 2026
Ce qui ne change PAS
Soyons honnêtes. Mistral Large 4 ne va pas magiquement résoudre vos problèmes d'organisation interne. Un modèle plus puissant sur une donnée mal structurée produit toujours des résultats médiocres. Les prérequis restent les mêmes : avoir des processus documentés, des sources de données propres, et une équipe qui comprend ce qu'elle automatise.
Deuxième point : la souveraineté ne se décrète pas en cochant une case. Héberger Mistral chez OVHcloud ne vous dispense pas d'une analyse d'impact RGPD, d'une politique de rétention des prompts, et d'un cadrage des usages internes. Les freins organisationnels à l'IA restent les mêmes qu'il y a six mois, on les documentait dans notre analyse des freins IA en TPE/PME et comment les lever.
Enfin, sur les tâches de raisonnement complexe (code avancé, mathématiques), GPT-5 et Claude Opus 4 gardent une avance mesurable. Mistral Large 4 n'est pas le meilleur partout. Il est suffisamment bon pour 85% des cas d'usage PME, avec un cadre juridique plus simple. C'est ce trade-off qu'il faut comprendre.
Comment vous positionner cette semaine
Créez un compte Mistral Studio et testez l'API sur un cas d'usage concret (ex : résumer vos 10 derniers emails clients). Comptez 2h pour un premier POC.
Identifiez 1 workflow critique où la souveraineté est un enjeu commercial (appel d'offres grand compte, secteur régulé). Chiffrez le temps gagné sur une semaine type.
Lancez un pilote de 30 jours avec Make ou n8n comme orchestrateur, Mistral Large 4 comme cerveau, et un périmètre volontairement restreint. Mesurez. Décidez ensuite d'étendre.
Si vous voulez qu'on regarde votre cas avant de vous lancer, on propose des audits gratuits de 30 minutes sur boommaker.io/audit-gratuit. On regarde ensemble si Mistral Large 4 est le bon choix pour vous, ou si un autre modèle fait mieux l'affaire sur votre cas précis.
FAQ : Mistral Large 4 : 5 Cas d'Usage Souverains pour PME (2026)
Mistral Large 4 est-il vraiment conforme RGPD ?
Mistral Large 4 peut être hébergé sur des infrastructures européennes (OVHcloud, Scaleway) ou on-premise grâce à ses poids ouverts, ce qui facilite la conformité RGPD. Attention toutefois : la conformité ne dépend pas que du modèle, elle dépend aussi de votre analyse d'impact, de votre politique de rétention des prompts et de votre contrat avec l'hébergeur. L'API publique de Mistral est hébergée en UE, mais une vraie souveraineté passe par un déploiement privé.
Quelle différence entre Mistral Large 4 et GPT-5 pour une PME ?
GPT-5 reste légèrement supérieur sur le raisonnement complexe (code avancé, mathématiques) et bénéficie d'un écosystème plus large. Mistral Large 4 est comparable sur 85% des cas d'usage PME (synthèse, extraction, génération, classification), coûte environ 40% moins cher en API, et offre une vraie option de souveraineté européenne. Si vous travaillez avec des clients régulés ou publics, Mistral prend l'avantage.
Peut-on utiliser Mistral Large 4 dans Make ou n8n ?
Oui, les deux plateformes supportent Mistral via des modules HTTP ou des connecteurs natifs. n8n a l'avantage d'être self-hosted, ce qui permet un workflow 100% souverain quand il est couplé à une API Mistral hébergée en UE. Make est plus simple à prendre en main mais fonctionne en SaaS. Pour un POC rapide, Make. Pour une architecture souveraine complète, n8n.
Combien coûte Mistral Large 4 pour une PME ?
Le pricing API est annoncé environ 40% inférieur à GPT-4 Turbo sur les tokens d'entrée. Pour une PME avec un usage modéré (quelques milliers de requêtes par mois), comptez entre 50 et 300€ par mois en API publique. Pour un hébergement souverain dédié chez OVHcloud ou Scaleway, le ticket d'entrée monte à environ 800-1500€/mois selon la puissance GPU nécessaire.
Faut-il attendre la version stable ou tester dès maintenant ?
La preview publique est accessible dès maintenant et stable pour des POC. Tester tôt vous donne un avantage de 3-6 mois sur vos concurrents qui attendront la GA. En revanche, pour un déploiement en production critique (facturation, données médicales), il est raisonnable d'attendre la version stable annoncée pour début 2026. Commencez par des cas d'usage internes à faible risque.